SlackTranslator – Bot de Tradução em Tempo Real
2025Tradutor Slack em tempo real focado em privacidade, construído em Ruby puro. Mensagens recebidas são traduzidas EN→PT por um LLM local (Ollama) e empurradas para uma UI web de duas colunas via SSE. Respostas são traduzidas de volta antes do envio, com etapa de confirmação para capturar erros do LLM. Sem chaves de API externas — toda inferência roda on-device.
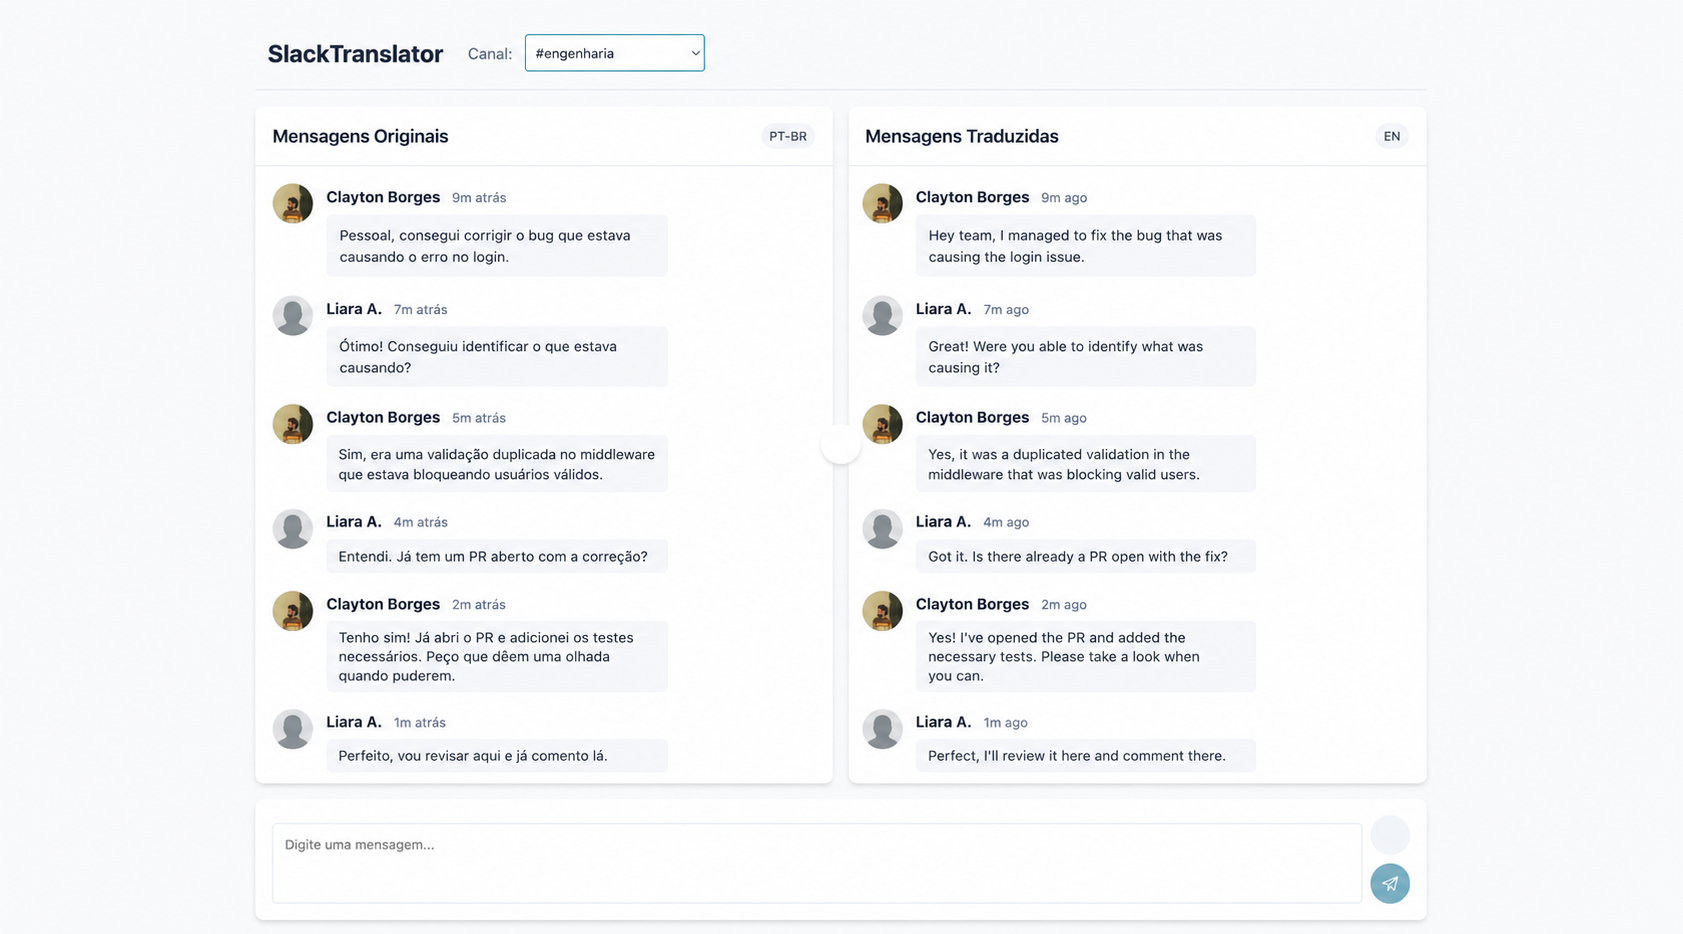
SlackTranslator é uma ferramenta de comunicação multilíngue em tempo real para o Slack que permite que falantes não nativos de inglês leiam e respondam no próprio idioma sem sair do fluxo de trabalho. Mensagens em inglês são capturadas via Socket Mode API do Slack (WebSocket), traduzidas para o português por um modelo Ollama local e empurradas para uma interface web de duas colunas em tempo real via SSE. Ao redigir uma resposta em português, ela é traduzida de volta para o inglês e exibida para confirmação antes de ser postada no Slack — evitando que erros do LLM cheguem aos colegas.
Times internacionais que usam Slack enfrentam um custo constante de atrito: falantes não nativos de inglês precisam traduzir mentalmente cada mensagem, redigir uma resposta em inglês e torcer para que a formulação soe natural. Essa carga cognitiva se acumula em conversas rápidas. APIs de tradução em nuvem (Google Translate, DeepL) resolvem o problema de tradução, mas introduzem um risco de privacidade — cada mensagem do canal é enviada a um servidor de terceiros. Para ambientes profissionais que lidam com discussões confidenciais, essa troca é inaceitável.
Construir uma camada de tradução Slack em tempo real que: (1) rode inteiramente on-device usando um LLM local, para que nenhuma mensagem saia da máquina; (2) transmita traduções para a UI conforme as mensagens chegam, sem polling; (3) permita ao usuário redigir respostas no próprio idioma e revisar a tradução em inglês antes de enviar; (4) mantenha estabilidade em desconexões WebSocket e múltiplas sessões simultâneas no browser.
- ◈Desenvolvedor solo — arquitetura, backend, frontend, DevOps
- 01Ruby puro com WEBrick (sem Rails/Sinatra) — escolha arquitetural deliberada para o contexto da entrevista técnica: demonstrar capacidade de construir roteamento HTTP, streaming SSE e integração WebSocket a partir de primitivas, em vez de depender de abstrações de framework.
- 02Slack Socket Mode API em vez da RTM API (descontinuada) — o Socket Mode usa WebSocket em vez de uma conexão HTTP persistente, eliminando a necessidade de uma URL de webhook pública e tornando o desenvolvimento local direto.
- 03Fila SSE com UUID por cliente — cada aba do browser registra um UUID (armazenado em cookie) e recebe sua própria fila em memória. A thread SSE lê dessa fila e escreve em um pipe consumido pelo corpo de resposta WEBrick. Isso evita vazamento de mensagens entre clientes e sobrevive a múltiplas sessões simultâneas sem problemas de estado mutável compartilhado.
- 04EVENT_QUEUE para processamento assíncrono de eventos Slack — eventos do Slack são empurrados para uma Queue sem limite e processados por uma thread dedicada, evitando que o handler WEBrick bloqueie durante a tradução Ollama (que pode levar de 2 a 15s dependendo do tamanho da mensagem e do modelo).
- 05Backoff exponencial com jitter ±20% no reconect WebSocket — evita thundering herd quando o Slack desconecta múltiplos clientes simultaneamente. O backoff dobra a cada tentativa, com teto de 30s. Uma thread watchdog separada força o reconnect se nenhum evento chegar em >30s.
- 06Ollama com Deepseek R1:14B — escolhido sobre modelos menores (Llama 3.1 8B foi usado na v1) pela qualidade de tradução significativamente melhor, especialmente para português brasileiro idiomático. O parâmetro `keep_alive: '5m'` mantém o modelo quente entre mensagens, reduzindo a latência do primeiro token de ~8s para ~1,5s nas requisições subsequentes.
- 07Etapa de confirmação de tradução antes do envio — a UI exibe a tradução EN da resposta PT do usuário antes de enviar ao Slack. Isso captura o principal modo de falha de LLMs locais: mistranslations ocasionais que seriam constrangedoras em um contexto profissional.
- 08SQLite em desenvolvimento / PostgreSQL em produção via Sequel ORM — a API de dataset do Sequel permite trocar o adaptador sem alterar o código de queries. Migrations ficam em db/migrations para que o schema seja versionado.
- 09Docker Compose com host.docker.internal para Ollama — o tradutor roda em container enquanto o Ollama roda no host (acesso à GPU). O recurso de gateway do Docker expõe a porta 11434 do host dentro do container sem configurações de rede complexas.
- →O isolamento de estado SSE exige identidade explícita por cliente desde o início. A primeira versão usava um array global compartilhado de IDs de clientes — qualquer nova mensagem era transmitida para todas as abas conectadas, causando mensagens duplicadas e fora de ordem. A troca para filas com chave UUID (sincronizadas por cookie entre a conexão SSE e o endpoint de mensagem) eliminou o problema completamente.
- →A latência de LLM local deve ser considerada no design, não ignorada. A primeira arquitetura chamava o Ollama de forma síncrona dentro do handler de requisição WEBrick — uma tradução de 10s bloqueava todas as outras requisições HTTP. Mover para uma EVENT_QUEUE processada por uma thread dedicada desacoplou completamente o tratamento de requisições do tempo de inferência.
- →Keepalive WebSocket é obrigatório com o Socket Mode do Slack. O Slack fecha conexões WebSocket ociosas silenciosamente após ~30s sem ping. Sem o timer de ping de 10 segundos e a thread watchdog, o app pareceria funcionar nos testes, mas pararia silenciosamente de receber mensagens em produção.
- →Ruby sem framework é um padrão de produção válido, não apenas um exercício. O WEBrick gerencia concorrência (via thread pool), streaming SSE (via pipes IO) e servir arquivos estáticos sem dependências adicionais. A restrição de não usar um framework forçou uma compreensão mais profunda de como servidores HTTP, SSE e clientes WebSocket se compõem no nível do socket.
- →A UX de confirmação de tradução é uma decisão de produto, não apenas uma rede de segurança. Os usuários descobriram que preferiam revisar a tradução mesmo quando estava correta — isso lhes dava confiança no que estavam enviando. A etapa de confirmação passou de capturadora de bugs para funcionalidade central do fluxo de trabalho.
Protótipo funcional — construído como teste técnico para entrevista de emprego